O
OmniHuman
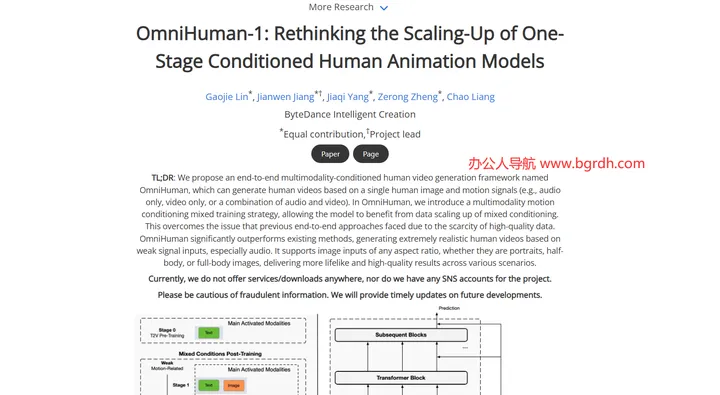
OmniHuman 是字节跳动推出的端到端多模态 AI 数字人生成框架。它能够仅凭 一张静态人物照片 与 音频(语音、音乐),自动生成 逼真的全身视频,实现人物说话、唱歌、演奏乐器、手势交互等多种动作与表情同步。
报错反馈
站点介绍
OmniHuman 是字节跳动推出的端到端多模态 AI 数字人生成框架。它能够仅凭 一张静态人物照片 与 音频(语音、音乐),自动生成 逼真的全身视频,实现人物说话、唱歌、演奏乐器、手势交互等多种动作与表情同步。
OmniHuman官网入口网址: https://omnihuman-lab.github.io/
关键特性
技术亮点
多模态运动条件混合训练:在训练阶段同时引入文本、音频、姿态等多种驱动信号,提升模型对弱信号(如仅音频)的生成质量。
支持任意宽高比输入:模型能够处理不同尺寸的图像,保持原有运动风格,适用于肖像、半身、全身等多种场景。
跨模态生成能力:除了音频驱动,还可接受姿态或视频驱动,实现更灵活的动画创作。
应用场景
短视频创作:快速生成带口型同步的宣传或带货视频。
虚拟主播/数字人:用于直播、教育培训中的虚拟形象。
影视特效:为角色动画提供高效的动作与表情合成。
游戏与动漫:将静态角色图像转化为动态演绎,提升互动体验。
OmniHuman 的应用场景能够显著降低制作成本、提升创作效率。OmniHuman 代表了 AI 数字人技术从“上半身动画”向“全身高保真视频”迈进的重要一步。
OmniHuman官网入口网址: https://omnihuman-lab.github.io/
关键特性
技术亮点
多模态运动条件混合训练:在训练阶段同时引入文本、音频、姿态等多种驱动信号,提升模型对弱信号(如仅音频)的生成质量。
支持任意宽高比输入:模型能够处理不同尺寸的图像,保持原有运动风格,适用于肖像、半身、全身等多种场景。
跨模态生成能力:除了音频驱动,还可接受姿态或视频驱动,实现更灵活的动画创作。
应用场景
短视频创作:快速生成带口型同步的宣传或带货视频。
虚拟主播/数字人:用于直播、教育培训中的虚拟形象。
影视特效:为角色动画提供高效的动作与表情合成。
游戏与动漫:将静态角色图像转化为动态演绎,提升互动体验。
OmniHuman 的应用场景能够显著降低制作成本、提升创作效率。OmniHuman 代表了 AI 数字人技术从“上半身动画”向“全身高保真视频”迈进的重要一步。
截图预览
🧭同分类推荐
 AutoResearchClaw
 是一款革命性的开源框架,它实现了从单一研究想法到完整学术论文的端到端全自动研究闭环。该项目深度集成于OpenClaw生态系统,旨在彻底消除科研过程中的人工重复劳动,让研究人员能够更专注于核心思想的碰撞,而非琐碎的格式调整与实验执行。
 Haystack
 是一个端到端的大型语言模型(LLM)框架,旨在帮助用户构建由 LLM、Transformer 模型、向量搜索等技术驱动的应用程序。无论您是希望执行检索增强生成(RAG)、文档搜索、问答或答案生成,Haystack 都能通过将最先进的嵌入模型和 LLM 组合成管道,来构建端到端的自然语言处理(NLP)应用并解决实际问题。
 Shimmy
 是一个开源的本地 AI 服务工具,旨在为用户提供一个隐私保护、高效且易于使用的本地 AI 推理环境。它通过提供 OpenAI 兼容的 API 接口,支持多种模型的本地运行,从而实现 AI 模型的本地化部署和使用。Shimmy 的核心目标是让用户在不依赖外部服务的情况下,能够高效地进行 AI 模型的训练和推理。