 NativeScript-Vue
Nativescript‑Vue 是把 Vue.js 的声明式组件化语法与 NativeScript 的原生渲染能力结合的开源框架,开发者可以使用熟悉的 Vue 语法直接编写 iOS 与 Android 的原生移动应用。它不依赖 WebView,而是将 Vue 组件编译为对应平台的原生 UI(如 iOS 的 UIButton、Android 的 android.widget.Button),从而获得接近原生的性能和体验。
Tesseract.js
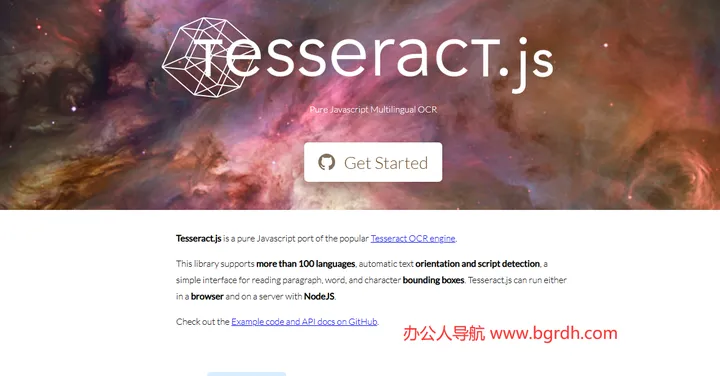
Tesseract.js 是一个基于 JavaScript 的开源 OCR(光学字符识别)库,使用 WebAssembly 将 Google 的 Tesseract OCR 引擎移植到浏览器和 Node.js 环境中。它可以在前端直接对图片进行文字提取,支持 100 多种语言(包括中、英、法、德等),适用于文档扫描、实时视频识别、移动端离线 OCR 等场景。
报错反馈
站点介绍
Tesseract.js 是一个基于 JavaScript 的开源 OCR(光学字符识别)库,使用 WebAssembly 将 Google 的 Tesseract OCR 引擎移植到浏览器和 Node.js 环境中。它可以在前端直接对图片进行文字提取,支持 100 多种语言(包括中、英、法、德等),适用于文档扫描、实时视频识别、移动端离线 OCR 等场景。
Tesseract.js官网入口网址: http://tesseract.projectnaptha.com/
Tesseract.js开源项目地址: https://github.com/naptha/tesseract.js
主要特性
跨平台:同时支持浏览器(通过 <script>、CDN、Webpack 等)和 Node.js 环境。
多语言:内置 100+ 语言的训练数据,中文(简体/繁体)识别效果良好。
WebAssembly 加速:核心 OCR 引擎以 WASM 形式运行,内存占用低、识别速度快。
并行处理:支持 createWorker 多线程工作者,可在后台并行识别多张图片。
模块化:提供 tesseract.js-core、语言数据(tessdata)分离,便于自行托管 CDN,避免网络不稳定导致加载失败。
轻量化:最新的 v6.0.0 进一步压缩文件体积、优化内存管理,适合长时间运行的 Web 应用。
Tesseract.js 通过 WebAssembly 将强大的 Tesseract OCR 引擎带到前端,具备跨平台、多语言、低内存、高性能等优势。只需几行代码即可在浏览器或 Node.js 中完成文字识别,配合 createWorker 与本地语言数据即可实现离线、批量、实时的 OCR 需求。
Tesseract.js官网入口网址: http://tesseract.projectnaptha.com/
Tesseract.js开源项目地址: https://github.com/naptha/tesseract.js
主要特性
跨平台:同时支持浏览器(通过 <script>、CDN、Webpack 等)和 Node.js 环境。
多语言:内置 100+ 语言的训练数据,中文(简体/繁体)识别效果良好。
WebAssembly 加速:核心 OCR 引擎以 WASM 形式运行,内存占用低、识别速度快。
并行处理:支持 createWorker 多线程工作者,可在后台并行识别多张图片。
模块化:提供 tesseract.js-core、语言数据(tessdata)分离,便于自行托管 CDN,避免网络不稳定导致加载失败。
轻量化:最新的 v6.0.0 进一步压缩文件体积、优化内存管理,适合长时间运行的 Web 应用。
Tesseract.js 通过 WebAssembly 将强大的 Tesseract OCR 引擎带到前端,具备跨平台、多语言、低内存、高性能等优势。只需几行代码即可在浏览器或 Node.js 中完成文字识别,配合 createWorker 与本地语言数据即可实现离线、批量、实时的 OCR 需求。
截图预览
🧭同分类推荐
NativeScript-Vue
Nativescript‑Vue 是把 Vue.js 的声明式组件化语法与 NativeScript 的原生渲染能力结合的开源框架,开发者可以使用熟悉的 Vue 语法直接编写 iOS 与 Android 的原生移动应用。它不依赖 WebView,而是将 Vue 组件编译为对应平台的原生 UI(如 iOS 的 UIButton、Android 的 android.widget.Button),从而获得接近原生的性能和体验。
 UniApp
 是由 DCloud 推出的 基于 Vue.js 的跨平台前端开发框架,旨在让开发者只写一套代码即可同时生成 iOS、Android、Web(H5)以及各类小程序(微信、支付宝、百度、字节跳动、QQ、钉钉、快手等)等多端应用。
 ReactNative
React Native 是由 Meta(前 Facebook)开源的跨平台移动应用框架,使用 JavaScript 或 TypeScript 编写 React 组件,能够一次代码同时生成 iOS 与 Android 原生应用。
 Pinia Colada
 是基于 Pinia 的轻量级、类型安全的数据获取层,提供 useQuery(读取)和 useMutation(写入)两个核心 API,帮助开发者在 Vue 项目中统一管理异步数据。它内置缓存、请求去重、加载状态、乐观更新等功能,并且对 SSR 与 Nuxt 有原生支持,体积小、可树摇、无额外依赖。
 WebSocket DevTools
 是一款专为 WebSocket 连接调试而设计的 Chrome/Edge/Brave 等 Chromium 系列浏览器的开发者工具扩展。它把原本“看不见、摸不着”的实时通信变成了可视化、可交互的调试面板,使开发者能够在页面中直接查看、拦截、修改和分析 WebSocket 消息,从而快速定位和解决通信问题。