 讯飞星火大模型
讯飞星火认知大模型,是由科大讯飞推出的新一代认知智能大模型,拥有跨领域的知识和语言理解能力,能够基于自然对话方式理解与执行任务,提供语言理解、知识问答、逻辑推理、数学题解答、代码理解与编写等多种能力。

DeepSeekOCR
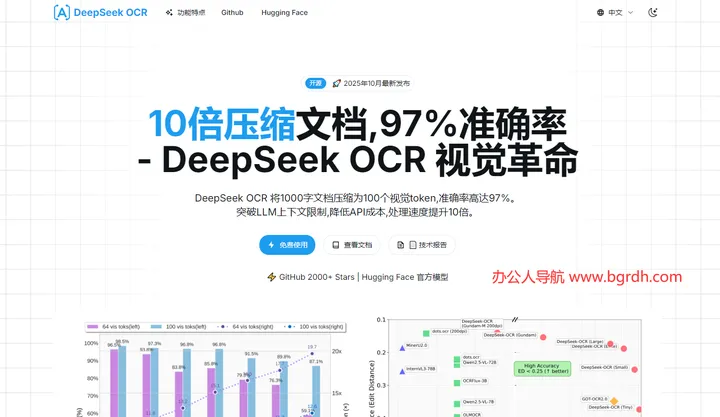
DeepSeek OCR(Optical Character Recognition)是由中国人工智能公司 DeepSeek AI 开发的一项前沿视觉语言模型(Vision Language Model, VLM),它不仅是一个传统的光学字符识别工具,更是为了解决大型语言模型(LLM)在处理长文本上下文时所面临的“高计算成本”和“记忆瓶颈”问题而设计的创新技术。
报错反馈
站点介绍
DeepSeek OCR(Optical Character Recognition)是由中国人工智能公司 DeepSeek AI 开发的一项前沿视觉语言模型(Vision Language Model, VLM),它不仅是一个传统的光学字符识别工具,更是为了解决大型语言模型(LLM)在处理长文本上下文时所面临的“高计算成本”和“记忆瓶颈”问题而设计的创新技术。
DeepSeekOCR官网入口网址: https://deepseekocr.site/
DeepSeekOCR开源项目地址: https://github.com/deepseek-ai/DeepSeek-OCR
核心技术:Context Optical Compression(上下文光学压缩)
DeepSeek OCR的最大创新点在于提出了“上下文光学压缩”(Contexts Optical Compression)的概念。传统的OCR技术通常是将图片中的文字提取为线性的文本字符串,而DeepSeek OCR则采用了一种全新的视觉处理范式。
它将长文档或大量文本内容渲染为高分辨率的图像,并利用其内部的DeepEncoder视觉编码器对图像进行深度分析。该编码器专为处理高分辨率输入而设计,能够在保持极低激活内存开销的同时,提取出极少量的视觉Token(视觉令牌)。
这些视觉Token可以被理解为“压缩后的上下文”,它们携带了原始文本的语义信息,却只占用了极少的计算资源。这种方法的优势在于,模型不再需要逐字逐句地处理整个文档,而是通过“阅读”这些视觉Token来获取全局上下文,从而极大地提升了长文档处理的效率和准确性。
主要功能与应用场景
除了核心的视觉压缩技术,DeepSeek OCR在实际应用中表现出了极高的通用性和智能化水平:
多模态文档理解:它不仅能提取文字,还能识别图像中的布局、表格结构,甚至可以对图片内容生成智能描述。
自定义任务:用户可以通过自定义提示语(Prompt)让模型执行特定任务,例如在图片中查找特定术语并标注位置(边界框),或是对文本进行特定格式的重排。
高效部署:得益于其视觉压缩的特性,DeepSeek OCR的模型参数量相对较小(如第一代版本约3B参数),在单张中高端显卡(如RTX 3060或A100)上即可流畅运行,且支持每日处理数千万页级别的文档。
升级迭代:2026年发布的DeepSeek OCR2进一步优化了视觉编码范式,引入了“视觉因果流”(Visual Causal Flow)技术,使得模型在阅读文档时能模仿人类的阅读逻辑,从而进一步降低了阅读顺序错误率,提升了在复杂文档解析基准(如OmniDocBench)上的性能。
开源与生态
DeepSeek OCR是一个开源项目,其模型及代码托管在GitHub和HuggingFace上。社区提供了包括React前端界面、FastAPI后端服务以及Electron桌面客户端在内的多种部署方案,极大地方便了开发者和企业用户的集成。
DeepSeek OCR不仅仅是一个“文字提取”工具,更是通过“视觉压缩”将文档处理推向了一个新的高度。它让AI不再局限于处理短文本,而是能够像人类一样,一眼看尽千页文档的精髓。无论是企业级的文档审计,还是个人的学习笔记整理,DeepSeek OCR都展示了AI在文档智能化领域的强大潜力。
DeepSeekOCR官网入口网址: https://deepseekocr.site/
DeepSeekOCR开源项目地址: https://github.com/deepseek-ai/DeepSeek-OCR
核心技术:Context Optical Compression(上下文光学压缩)
DeepSeek OCR的最大创新点在于提出了“上下文光学压缩”(Contexts Optical Compression)的概念。传统的OCR技术通常是将图片中的文字提取为线性的文本字符串,而DeepSeek OCR则采用了一种全新的视觉处理范式。
它将长文档或大量文本内容渲染为高分辨率的图像,并利用其内部的DeepEncoder视觉编码器对图像进行深度分析。该编码器专为处理高分辨率输入而设计,能够在保持极低激活内存开销的同时,提取出极少量的视觉Token(视觉令牌)。
这些视觉Token可以被理解为“压缩后的上下文”,它们携带了原始文本的语义信息,却只占用了极少的计算资源。这种方法的优势在于,模型不再需要逐字逐句地处理整个文档,而是通过“阅读”这些视觉Token来获取全局上下文,从而极大地提升了长文档处理的效率和准确性。
主要功能与应用场景
除了核心的视觉压缩技术,DeepSeek OCR在实际应用中表现出了极高的通用性和智能化水平:
多模态文档理解:它不仅能提取文字,还能识别图像中的布局、表格结构,甚至可以对图片内容生成智能描述。
自定义任务:用户可以通过自定义提示语(Prompt)让模型执行特定任务,例如在图片中查找特定术语并标注位置(边界框),或是对文本进行特定格式的重排。
高效部署:得益于其视觉压缩的特性,DeepSeek OCR的模型参数量相对较小(如第一代版本约3B参数),在单张中高端显卡(如RTX 3060或A100)上即可流畅运行,且支持每日处理数千万页级别的文档。
升级迭代:2026年发布的DeepSeek OCR2进一步优化了视觉编码范式,引入了“视觉因果流”(Visual Causal Flow)技术,使得模型在阅读文档时能模仿人类的阅读逻辑,从而进一步降低了阅读顺序错误率,提升了在复杂文档解析基准(如OmniDocBench)上的性能。
开源与生态
DeepSeek OCR是一个开源项目,其模型及代码托管在GitHub和HuggingFace上。社区提供了包括React前端界面、FastAPI后端服务以及Electron桌面客户端在内的多种部署方案,极大地方便了开发者和企业用户的集成。
DeepSeek OCR不仅仅是一个“文字提取”工具,更是通过“视觉压缩”将文档处理推向了一个新的高度。它让AI不再局限于处理短文本,而是能够像人类一样,一眼看尽千页文档的精髓。无论是企业级的文档审计,还是个人的学习笔记整理,DeepSeek OCR都展示了AI在文档智能化领域的强大潜力。
截图预览
🧭同分类推荐
讯飞星火大模型
讯飞星火认知大模型,是由科大讯飞推出的新一代认知智能大模型,拥有跨领域的知识和语言理解能力,能够基于自然对话方式理解与执行任务,提供语言理解、知识问答、逻辑推理、数学题解答、代码理解与编写等多种能力。
 千问
通义千问是一个由阿里云自主研发的大语言模型,最接近ChatGPT水平的国产AI模型。通义千问具备强大的语言理解和生成能力,能够提供多轮对话、文案创作、逻辑推理、长文档处理功能等服务。通义千问的功能包括多轮对话、文案创作、逻辑推理等。通义千问免费开放了1000万字的长文档处理功能,是全球文档处理容量第一的AI应用。
 讯飞星辰MaaS
(Model as a Service)平台是科大讯飞推出的前沿AI技术服务平台,旨在解决企业在大模型应用落地中面临的“算力不足、技术门槛高、部署难”的痛点。平台采用“模型即服务”的理念,整合了星火大模型、DeepSeek、Llama等国内外主流模型资源,提供从模型评选、数据处理、微调训练到部署应用的一站式全链路解决方案,帮助用户快速构建专属的大模型应用。
 DeepSeek
深度求索(DeepSeek),成立于2023年,专注于研究世界领先的通用人工智能底层模型与技术,挑战人工智能前沿性难题。基于自研训练框架、自建智算集群和万卡算力等资源,深度求索团队仅用半年时间便已发布并开源多个百亿级参数大模型,如DeepSeek-LLM通用大语言模型、DeepSeek-Coder代码大模型,并在2024年1月率先开源国内首个MoE大模型(DeepSeek-MoE),各大模型在公开评测榜单及真实样本外的泛化效果均有超越同级别模型的出色表现。和 DeepSeek AI 对话,轻松接入 API。
 怪兽AI知识库大模型
企业知识库大模型 + 智能的AI问答机器人
 AI Ping
 是一个专注于大模型服务性能评测的平台,由清华系人工智能企业清程极智推出,被誉为“大模型服务界的大众点评”。该平台旨在通过全面、客观、真实的评测数据,为开发者和企业提供大模型服务商的多维度参考,帮助其快速选择最适合的模型服务,提升AI产品开发效率与服务质量。